Meta Ungkap Detail Superkluster Prometheus: Skala Gigawatt Menuju 1 Juta GPU
Engineering at Meta membeberkan cetak biru teknis superkluster Prometheus di New Albany, Ohio, yang dirancang menampung hingga 1 juta GPU NVIDIA GB200/GB300 dengan jaringan 51,2T RoCE, goodput training di atas 85%, dan stabilisator lonjakan daya Dynamo Dimmer.
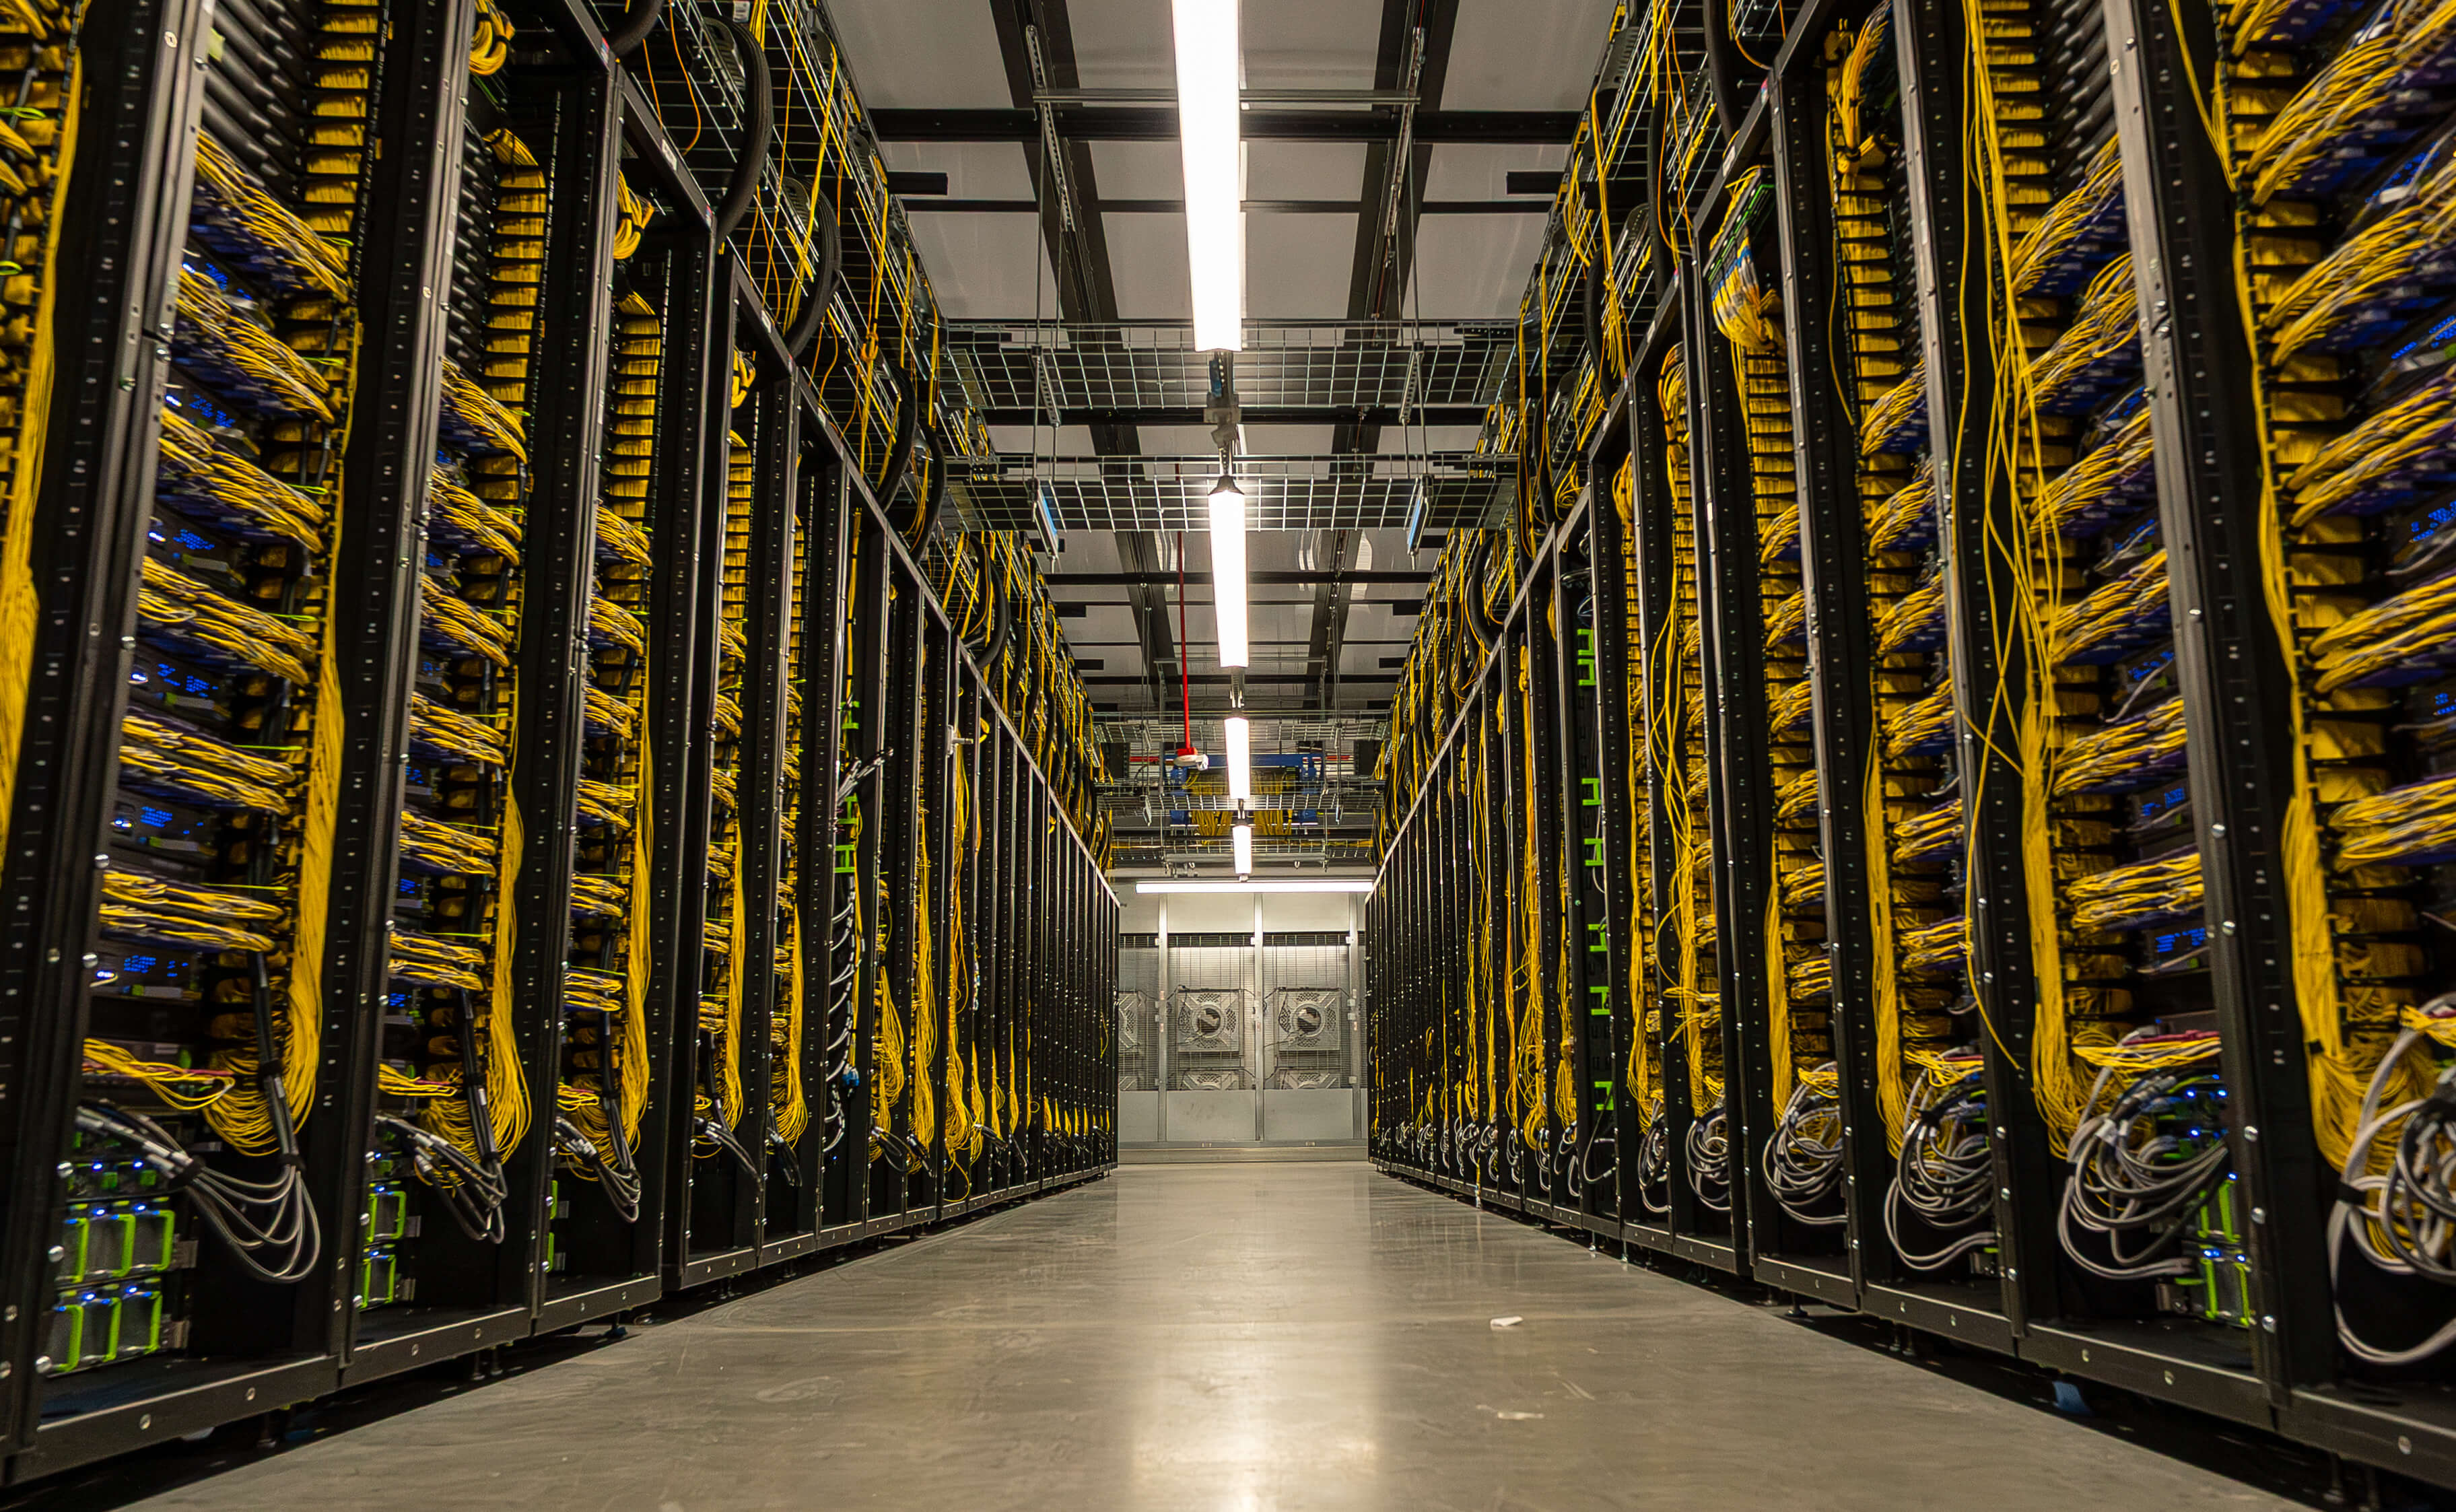
Divisi rekayasa infrastruktur Meta (Engineering at Meta) secara resmi mempublikasikan perincian arsitektural mendalam mengenai 'Prometheus', fasilitas superkluster kecerdasan buatan berskala gigawatt yang berlokasi di New Albany, Ohio. Superkomputer masif ini merupakan fondasi komputasi fisik di balik pelatihan model fondasi generasi terbaru Meta, termasuk keluarga model Muse dan model penalaran frontier Muse Wonder.
Fasilitas New Albany—yang dua tahun lalu masih beroperasi sebagai pusat data konvensional untuk melayani lalu lintas aplikasi sosial Meta—kini telah menyelesaikan pembangunan tahap pertamanya. Kluster ini telah mengaktifkan ratusan ribu akselerator GPU yang tersebar di beberapa bangunan terhubung, dan dirancang secara bertahap menuju target kapasitas penuh yang menampung hingga 1 juta GPU bekerja serempak dalam satu jaringan komputasi terdistribusi.
Evolusi Tiga Generasi Rak Silikon: Catalina, Clemente, dan San Miguel
Arsitektur perangkat keras Prometheus sepenuhnya bertumpu pada silikon NVIDIA generasi terdepan dengan desain rak berpendingin cairan tertutup (closed-loop liquid cooling) berdensitas tinggi:
- Platform Catalina: Rak NVIDIA GB200 NVL72 yang memadukan 72 GPU Blackwell dengan memori berkecepatan tinggi HBM3e sebesar 13,4 Terabyte per rak tunggal.
- Platform Clemente: Rak NVIDIA GB300 NVL72 generasi berikutnya yang meningkatkan kapasitas memori HBM3e hingga 20,7 Terabyte per rak untuk menampung bobot model penalaran ekstrem tanpa offloading.
- Platform San Miguel: Rak komputasi masa depan berbasis arsitektur Vera Rubin NVL72 yang dijadwalkan segera memasuki fase penyebaran di gedung ekspansi baru.
Topologi Jaringan 51,2T RoCE dan Fabric Antar-Gedung BAG
Untuk menyatukan ratusan ribu akselerator tanpa bottleneck komunikasi, Meta memilih fabric berbasis RoCEv2 (RDMA over Converged Ethernet) alih-alih InfiniBand tertutup. Di dalam setiap gedung data center, jaringan spine-leaf menghubungkan hingga 20.736 GPU pada non-blocking fabric menggunakan switch generasi 51,2 Tbps.
Sementara itu, untuk menghubungkan beberapa kompleks gedung yang berjarak antara 2 kilometer hingga lebih dari 100 kilometer, Meta membangun jaringan agregasi backend khusus bernama Backend Aggregation (BAG). Fabric BAG ini mengorkestrasi paralelisasi data dan pipeline melintasi kampus tanpa penurunan bandwidth yang berarti.
Keandalan SRE: MTBI 54 Ribu Jam-GPU dan Goodput Latihan >85%
Pada skala ratusan ribu chip, tantangan operasional terbesar bukanlah kecepatan teoretis, melainkan keandalan sistem. Meta mengungkapkan bahwa metrik 'Goodput'—proporsi waktu latihan yang benar-benar menghasilkan kemajuan bobot model tanpa terbuang oleh kegagalan sistem—mencapai di atas 85% untuk pre-training dan menembus 90% pada fase reinforcement learning Muse Wonder.
Waktu rata-rata antar-gangguan (Mean Time Between Interruptions / MTBI) berhasil ditingkatkan dari 47 ribu jam-GPU menjadi lebih dari 54 ribu jam-GPU pasca-optimalisasi firmware dan kerja sama tim insinyur NVIDIA yang ditempatkan langsung di lokasi. Angka gangguan ini anjlok hingga 99% dari titik terburuk pada pertengahan 2025 yang sempat mencapai hampir 1.000 insiden per 8.000 GPU per hari.
Manajemen Ayunan Daya 30–40% via Perangkat Lunak 'Dynamo Dimmer'
Pelatihan serentak model frontier pada ratusan ribu GPU memicu fenomena fisik ekstrem: ayunan konsumsi daya instan sebesar 30% hingga 40% (setara puluhan megawatt) hanya dalam hitungan milidetik saat fase komputasi berganti ke fase komunikasi kolektif (All-Reduce). Lonjakan mendadak ini berisiko merusak trafo gardu listrik lokal.
Untuk menstabilkan jaringan listrik, tim rekayasa Meta mengembangkan software cerdas 'Dynamo Dimmer'. Sistem ini secara dinamis membatasi frekuensi dan daya GPU sebelum fase transisi, dipadukan dengan instalasi bank kapasitor berdaya respon tinggi, baterai penyangga terintegrasi di setiap rak (in-rack BBU), serta koordinasi telemetri real-time dengan perusahaan utilitas listrik regional.
- Superkluster Prometheus tahap pertama resmi beroperasi di New Albany, Ohio, membidik target skala 1 juta GPU
- Menggunakan rak terakselerasi berpendingin cairan Catalina (GB200), Clemente (GB300), dan persiapan Vera Rubin (San Miguel)
- Jaringan Ethernet 51,2T RoCE menghubungkan 20.736 GPU per domain, didukung jaringan antar-gedung Backend Aggregation (BAG)
- Efisiensi goodput pelatihan mencapai >85% pada pre-training dan >90% pada fine-tuning RLHF Muse Wonder
- Toleransi kegagalan N+8: dari 72 GPU per rak, 64 digunakan untuk komputasi dan 8 dialokasikan sebagai suku cadang panas (hot spares)
- Mengatasi lonjakan daya puluhan megawatt dengan software kontrol 'Dynamo Dimmer' dan baterai rak
“Di skala komputasi gigawatt, hukum fisika pusat data berubah secara fundamental. Suksesnya pelatihan AI frontier tidak lagi ditentukan oleh siapa yang membeli chip paling cepat, melainkan siapa yang mampu menguasai manajemen ayunan daya, keandalan firmware, dan mitigasi kegagalan perangkat keras tanpa menghentikan komputasi.”
Cetak biru Prometheus membuktikan bahwa Meta tidak hanya menjadi konsumen chip komputasi terbesar, tetapi juga pelopor rekayasa pusat data yang menetapkan standar baru bagi pembangunan klaster kecerdasan buatan skala gigawatt global.
Rujukan & Sumber Primer
Artikel Terkait & Analisis Lanjutan
Meta Muse Spark Open: Model 816B di Apple M5 Ultra
Meta meluncurkan bobot model Muse Spark Open berkapasitas 816 miliar parameter dengan jendela konteks 1 juta token, menghadirkan eksekusi agen otonom dan multimodal langsung di desktop Mac Studio menggunakan framework Apple MLX.
OpenAI Percepat Penggalangan Dana US$30 Miliar dengan Valuasi US$1,4 Triliun Jelang IPO Anthropic
OpenAI dilaporkan mempercepat putaran pendanaan baru senilai US$30 miliar dengan target valuasi melampaui US$1,4 triliun guna mengamankan komitmen investor institusional sebelum IPO Anthropic digelar pertengahan November.
MiniMax Rilis M3.1 Flash: Model Agen Otonom 3x Lebih Cepat dan 70% Lebih Hemat Biaya
Perusahaan AI asal Tiongkok, MiniMax, meluncurkan model M3.1 Flash yang dioptimalkan untuk siklus agen otonom, rekayasa kode, dan computer use, menghadirkan kecepatan inferensi 3x lipat, pemangkasan biaya 70%, serta rencana pembukaan bobot model (open weights).